
Questão FC100118
Um modelo de regressão linear entre uma variável aleatória (dependente) e uma variável não aleatória X (independente) é definido por Y = β0 +β1 X+ε, em que ε, denominado erro aleat
Regressão
CEBRASPE (CESPE) · 2024
 para os parâmetros β0 e β1 e definir o
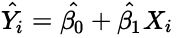 como o estimador para Yi. Nesse contexto, são definidos os erros, denominados resíduos, como
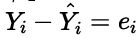 , a soma dos quadrados dos resíduos
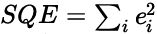 , a soma dos quadrados totais e a soma dos quadrados totais
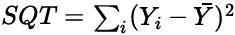 e a soma dos quadrados de regressão
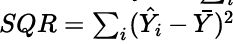 , com
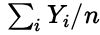 .
Com base nessas informações, julgue o próximo item, considerando uma variável T, com média nula e desvio padrão unitário, definida por uma distribuição t de Student com 30 graus de liberdade, que tenha o seguinte intervalo com probabilidade de 0,95: P(−2,042 < 1 < 2,042) = 0,95
Um estimador não viciado para a variância de
 é obtido pela variância amostral dada por
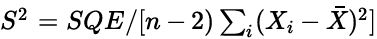 , em que
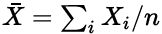 e a variável centralizada de , normalizada por S, tem uma distribuição t de Student com − 1 graus de liberdade.
Mostrar resposta e comentário
Gabarito
Errado
Comentário do professor
Comentário: A assertiva em questão carece de precisão ao abordar a variância do estimador, especialmente no contexto de regressão linear simples. O correto é que a variância do estimador \( \hat{\beta}_1 \) é dada por \( \text{Var}(\hat{\beta}_1) = \frac{\sigma^2}{\sum_{i} (X_i - \bar{X})^2} \). Contudo, como não conhecemos a variância populacional \( \sigma^2 \), usamos o estimador amostral da variância, que é \( \hat{\sigma}^2 = \frac{SQE}{n-2} \), onde SQE representa a soma dos quadrados dos erros. Isso significa que o estimador para a variância de \( \hat{\beta}_1 \) torna-se \( \frac{\hat{\sigma}^2}{\sum_{i} (X_i - \bar{X})^2} \). Além disso, a afirmativa menciona \( \beta_i \), o que é uma confusão, pois deveríamos considerar os estimadores \( \hat{\beta}_0 \) e \( \hat{\beta}_1 \) separadamente, tendo em vista que cada um possui sua própria variância. Para o intercepto \( \hat{\beta}_0 \), sua variância é expressa como \( \text{Var}(\hat{\beta}_0) = \frac{\sigma^2}{n} + \frac{\bar{X}^2}{\sum_{i} (X_i - \bar{X})^2} \). Logo, a afirmação se torna errônea, pois não leva em consideração a variância associada a \( \hat{\beta}_0 \) e falha em estabelecer uma conclusão correta sobre a variância do estimador proposto.
Conteúdo do catálogo FC Concursos · Atualizado em